
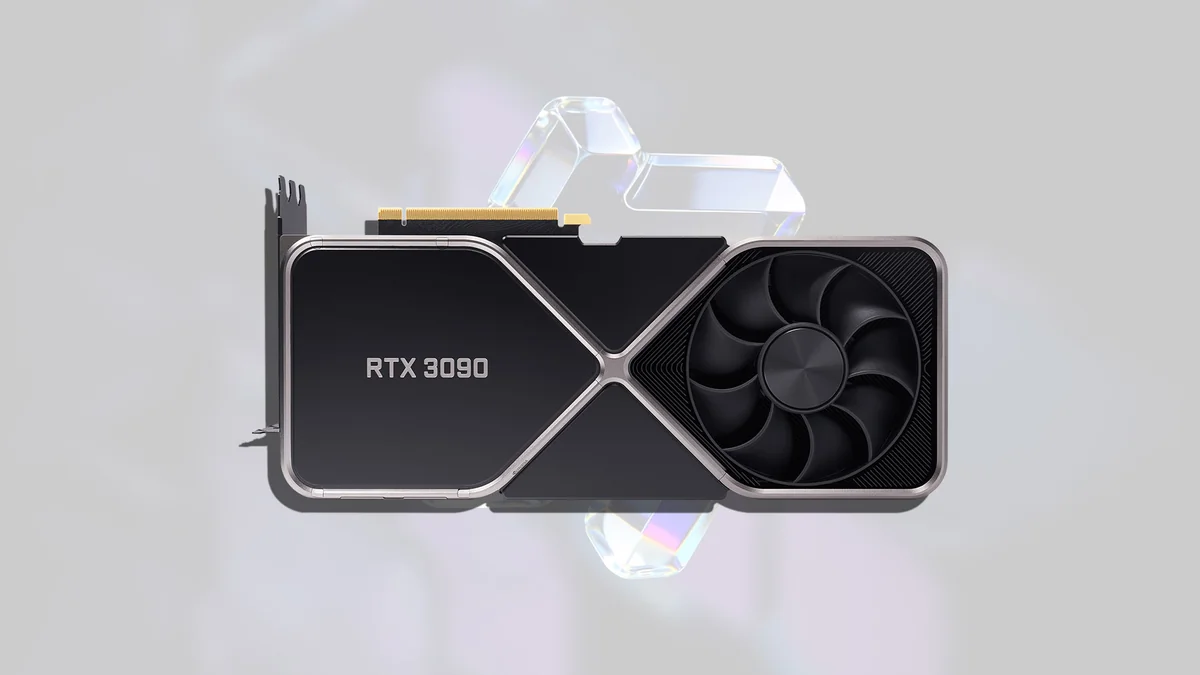
RTX 3090 postiže 382 tok/s na 27B modelu zahvaljujući optimizacijama
Jedan programer uspeo je da drastično ubrza generisanje teksta na NVIDIA RTX 3090 grafičkoj kartici, bez ikakvog nadogradnje hardvera. Pokretanjem modela Qwen3.8-27B, brzina je porasla sa početnih 82 tok/s na čak 382 tok/s, što predstavlja povećanje od 4,6 puta.
Zašto je generisanje tokena sporo?
Svaki LLM model piše jedan token po jednom, a za svaki token procesor mora da povuče celokupne težine modela iz memorije. Upravo to učitavanje iz memorije, a ne samo računanje, predstavlja usko grlo. RTX 3090 ima 24GB VRAM-a i memorijsku propusnost od 936,2 GB/s, što je solidna osnova, ali zahteva pametne optimizacije.
Kako su postignuta ubrzanja?
Programer je primenio tehniku zvanu spekulativno dekodiranje — brži „nacrtač“ predlaže nekoliko narednih tokena, a glavni model ih sve proverava odjednom. Tačnost na matematičkom benchmarku ostala je stabilna na 96,5%.
Brzine su rasle u fazama:
– Podešavanjem ugrađene MTP funkcije: 114 tok/s
– Dodavanjem metode DFlash2 (7 tokena odjednom): 138 tok/s
– Kombinovanjem „lookup“ nacrta i provere 16 tokena po koraku: do 382 tok/s na dugim dokumentima
Kada model citira dokument, oko 15 od 16 predloženih tokena biva prihvaćeno, što dramatično ubrzava rad.
Dodatne pogodnosti i ograničenja
Kontekstni prozor je proširen na 138.696 tokena zahvaljujući kompaktnijem formatu memorije. Ipak, ovaj režim udvostručava vreme učitavanja dokumenta, pa je pogodan za scenarije gde se dokument učitava jednom, a zatim se postavljaju brojna pitanja.
Za svakodnevni čet, može se očekivati oko 133 tok/s, što je i dalje solidno poboljšanje u odnosu na početnih 82.
I pushed Qwen3.8-27B to 381 tps for a single request on a RTX 3090
byu/iamMess inLocalLLaMA