
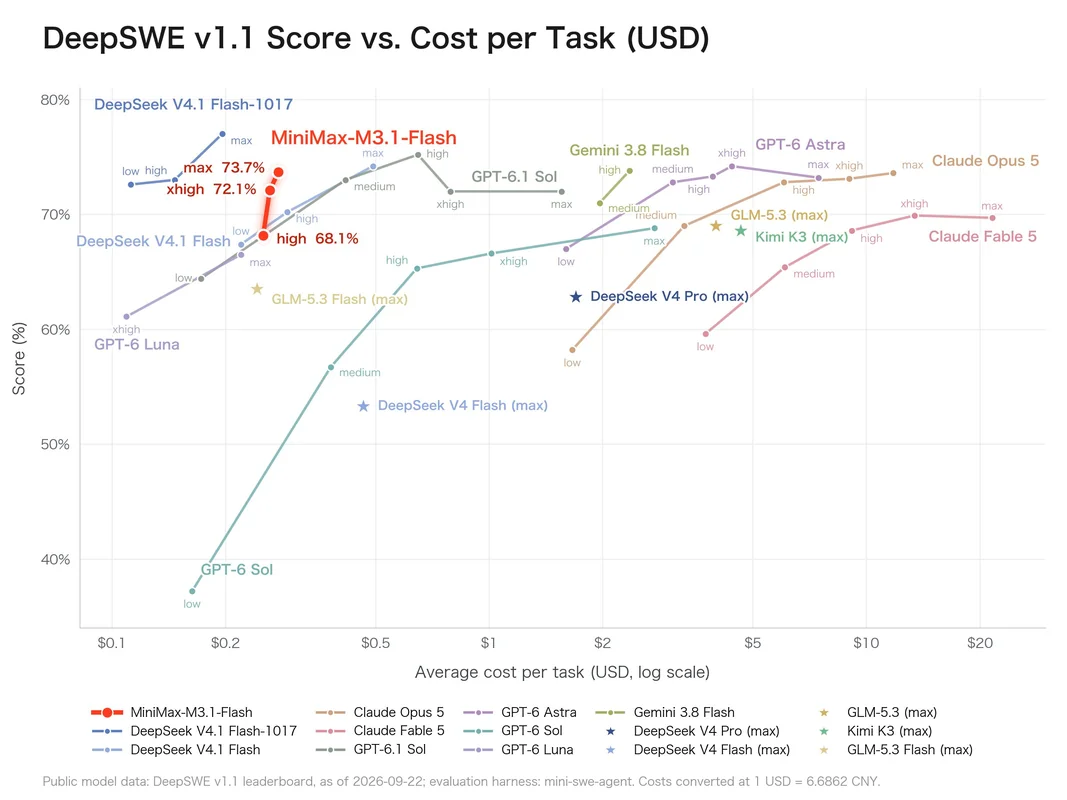
Kineski AI laboratoriji MiniMax i DeepSeek raspolažu sa manje od 100.000 H100-ekvivalentnih GPU-ova, a ipak nastavljaju da postavljaju nove standarde na globalnim AI benchmark listama. Najnoviji model, MiniMax M3.1 Flash, upravo je preuzeo primat od DeepSeek-V4.1-Flash-1017 na benchmark listi agentic AI zadataka po ceni.
https://x.com/MiniMax_AI/status/2112150867868541221
MiniMax M3.1 Flash dolazi sa 428 milijardi ukupnih parametara i svega 23 milijarde aktivnih, a cena je izuzetno niska – $0,15 po milion ulaznih i $0,60 po milion izlaznih tokena. Model trenutno vodi na tri globalna benchmarka: Automation Bench, Banker ToolBench i LOCA-Bench-256K.
Tehnološke inovacije iza modela
Ključna inovacija je MiniMax Sparse Attention (MSA) framework koji kompresuje KV cache u blokove, pri čemu se samo 6–7% najrelevantnijih blokova šalje na puno procesiranje. Rezultat je smanjenje compute zahteva po tokenu na 1/20 standardnih troškova, uz ubrzanje prefill faze za 9x i decode faze za 15x.
https://x.com/testingcatalog/status/2112155774898040898
Ograničeni resursi, neočekivani rezultati
Podaci pokazuju da MiniMax ima samo 70.000 H100-ekvivalentnih GPU-ova, dok DeepSeek raspolaže sa tek 47.000 – nasuprot 3,7 miliona koje poseduje OpenAI.
https://x.com/Chinazhidx/status/2112150441903472710
Uprkos tome, oba kineska modela beleže manje halucinacija nego što bi se očekivalo od modela koji koriste distilaciju znanja. Stručnjaci napominju da intenzivna SFT distilacija tipično povećava halucinacije, što otvara pitanje kako kineski laboratoriji održavaju ovaj nivo kvaliteta uz tako skromne compute resurse.
https://x.com/teortaxesTex/status/2112105974869709237
Kompanije Anthropic i OpenAI pojačale su mere protiv distilacije, što bi moglo ugroziti buduću trajektoriju kineskih AI laboratorija.